TCP keepalive: соединение живо, а телеметрия остановилась
Длительное TCP соединение удобно для шлюза на ферме, но его наличие не доказывает работоспособность всех компонентов. Сетевой стек может отвечать, пока обработчик измерений перестал обновлять данные. Поэтому транспортный контроль и проверку полезного результата проектируют как разные уровни наблюдения.
Разделить признаки исправности
Зафиксируйте, что именно показывает каждый индикатор: открытое соединение, полученный ответ программы, свежую запись измерения или успешное сохранение в архив. Для каждого признака нужен собственный источник. Нельзя обозначать всё одним зелёным кружком, если оператор не понимает предел подтверждения.
TCP и его механизм keepalive рассматриваются в RFC9293. (RFC Editor — RFC 9293, Transmission Control Protocol) Фактическую поддержку и настройки проверяют в используемом стеке. Ответ транспортного уровня не является прикладным отчётом о текущем состоянии датчика, контроллера или сервера хранения.
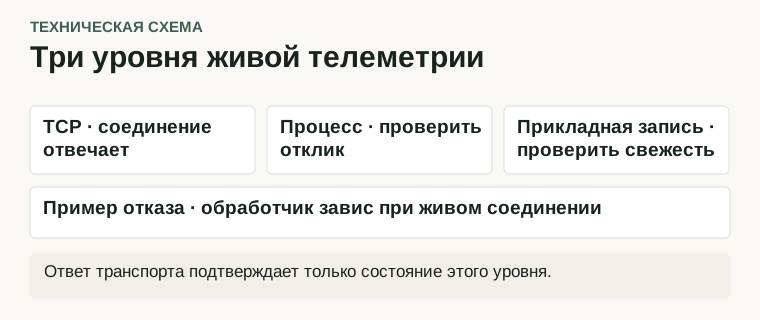
Сделать контроль содержательным
Для приложения определите безопасный запрос, который проверяет нужную рабочую функцию. Он должен иметь различимый идентификатор и понятный ожидаемый ответ. Если тест отвечает из отдельного служебного потока, это ограничение важно: основной обработчик может оставаться остановленным.
Сохраняйте возраст последней полезной записи отдельно от момента сетевого ответа. Если клиент отправляет постоянный шаблон без обновления исходных данных, служебный обмен выглядит исправным. Проверка должна показывать, от какого источника и какого цикла получено подтверждение.
Испытать частичные неисправности
На стенде раздельно создайте разрешённые сценарии потери сети, остановки прикладного обработчика и недоступности хранилища. Наблюдайте, какие индикаторы меняются. Одинаковая реакция на все случаи может быть допустима только тогда, когда она соответствует эксплуатационной задаче и явно описана.
Автоматическое действие назначают по подтверждённой причине и допустимым последствиям. Перезапуск всего шкафа из-за медленного сервера способен повредить доступность других функций. Общие принципы восстановления OT приведены в NIST. (NIST SP 800-82 Rev.3 — Guide to Operational Technology Security) Локальное управление и защиты объекта сохраняют свои независимые требования.
Передать понятную лестницу диагностики
Диспетчеру полезны отдельные состояния транспорта, приложения и данных. Инженер получает журналы переходов и настройки проверок. Повторное соединение считается восстановлением только после предусмотренного полезного результата, а не после открытия сокета.
При выборе интервалов учтите обычную длительность обработки и допустимый трафик. Слишком агрессивная проверка способна создавать ложные отказы при штатной нагрузке. Зафиксируйте основание параметров и повторите испытание на реальной последовательности обмена, включая периоды, когда датчик законно не создаёт новых измерений.